组会分享——具身智能中的反馈机制
本文最后更新于 2026年9月29日 18:45:41
I. Feedback World Model Enables Precise Guidance of Diffusion Policy
1、引入
在 World Model 中,机器人每次执行完动作都能观察到真实的执行状态。作者认为,预测与真实状态的不匹配恰恰提供了一种重要的信息。利用这种不匹配信息,作者提出了一种轻量化的反馈模块。它不需要额外的训练数据或参数更新,并利用实时反馈在线修正模型,使模型在 distribution shift 的情形下依然做出可靠的预测。同时,作者通过强调 World Model 预测中与动作相关的部分,让反馈信息更好地转化为控制信息。
2、前置知识
在这篇研究中,作者使用 Diffusion Policy 作为 WM,通过修改 score function 达到引导去噪方向的目的。其中 score function 的定义如下,它描述了当前动作序列在条件概率分布下,对数概率密度增长最快的方向。其原理与图像生成一致,都可以利用 Score,逐步将初始随机噪声转化为符合当前观测与任务条件的动作序列。 \[ s_\phi\left(A_t^{(\tau)}, O_t, \ell, \tau\right) \approx \nabla_{A_t^{(\tau)}} \log p_\tau\left(A_t^{(\tau)} \mid O_t, \ell\right), \] 而通过在 score function 的基础上增加一个指导项,我们能够达到引导动作生成的目的: \[ \tilde{s}\left(A_t^{(\tau)}, O_t, \ell, \tau\right) = s_\phi\left(A_t^{(\tau)}, O_t, \ell, \tau\right) + \lambda g\left(A_t^{(\tau)}, O_t\right) \] 具体而言,将专家示范中的观测编码为 expert latent 集合 \(Z^E=\{z_i^E\}_{i=1}^{N}\)。对于当前候选动作序列\(A_t^{(\tau)}\),使用世界模型预测下一时刻 latent,并在专家示范中检索距离最近的 expert latent,假设其编号为\(i^*\),得到: \[ i^* = \arg\min_i \left\| \hat{z}_{t+1}\left(A_t^{(\tau)}\right) - z_i^E \right\|_2^2 \] 之后将模型预测与\(z_{i^*}\)之间的距离当作指导能量,对其求偏导来影响 DP 的打分: \[ E\left(A_t^{(\tau)}\right) = \left\| \hat{z}_{t+1}\left(A_t^{(\tau)}\right) - z_{i^*}^{E} \right\|_2^2 \] \[ \tilde{s} = s_\phi - \lambda \nabla_{A_t^{(\tau)}} E\left(A_t^{(\tau)}\right) \] 作者提到这种方法有两条缺陷:
- distribution shift:推理时的数据没见过,且预测误差会随着时间累积
- L2 损失中每个维度的权重是相同的。但潜空间中与 action 有关的维度应该被赋予更高的权重,其他的应该过滤掉
对应地,作者提出了两种改进方法:
- 通过 feedback 模块修正模型预测,使其更接近实际观测
- 识别潜空间中与动作相关的维度,并赋予它们更高的权重,使引导项更关注与实际执行有关的部分
3、Feedback 模块
第一部分是 feedback 模块。作者首先定义了\(v_t\)。这里的\(f_\theta\)是 World Model,\(z_{t}\)是 obs 在潜空间上的编码,\(\tau\)在这里是 DP 的去噪时间步。World Model 负责根据 latent 和 action 输出预测的下一状态。 \[ v_t\left(A_t^{(\tau)}\right) \triangleq \frac{ f_\theta\left(z_t, A_t^{(\tau)}\right)-z_t }{ \delta t } = \frac{ \hat{z}_{t+1}-z_t }{ \delta t } \] 模型需要额外维护 belief 模块\(\bar{z}_t\),代表模型对于\(t\)时刻机器人状态的认识。误差项 error 被定义成模型认识与 ground truth 之间的差值。 \[ e_t = z_t - \bar{z}_t \] 接着,作者用误差项线性修正 World Model 预测的速度和潜空间状态 \[ \begin{cases} \hat{v}_t\left(A_t^{(\tau)}\right) = v_t\left(A_t^{(\tau)}\right)+Le_t,\\[4pt] z_{t+1}^{\mathrm{fb}}\left(A_t^{(\tau)}\right) = z_t+\delta t\cdot \hat{v}_t\left(A_t^{(\tau)}\right), \end{cases} \]
4、Action-aware guidance
作者认为单纯根据 ground truth 对模型进行修正还不够,需要进一步降低潜空间中与 action 无关部分的影响,比如背景和物体外观。 因此,作者进固定当前状态\(z_t\),改变 action,观察 WM 预测输出中随 action 变化方差最大的各个维度,并赋予它们更高的权重。 最终用处理后的权重计算 Energy,即模型预测状态与专家示范状态之间的加权 L2 损失,用于衡量当前候选动作的预测结果与专家示范之间的差异: \[ E_{\mathrm{ctrl}}\left(A_t^{(\tau)}\right) = \sum_{j=1}^{D} w_j^{(\beta)} \left( z_{t+1,j}^{\mathrm{fb}}\left(A_t^{(\tau)}\right) - \hat{z}_{i^*,j}^{E} \right)^2 \] 通过对 Energy 关于候选动作求负梯度,可以得到对应的动作调整方向,并将其作为 Guidance Term 注入 DP 的去噪过程。
5、实验
回答两个问题:
- FeedbackWM 能不能在线地减少 Out Of Distribution 情况下的预测错误
- 作者设计的加权L2损失能否进一步提升 Diffusion Policy 在 Out Of Distribution 情形下的成功率
5.1 环境部署
模拟:
- Robomimic(Square, Tool-Hang, and Transport),仅使用官方示例的20%数据进行训练
- LIBERO-Plus(four single-task settings from the Kitchen and Living Room (LR) scenes, focusing on the official robot initial-state perturbation category.)
LIBERO-Plus 是在原始 LIBERO 上系统地制造受控 distribution shift,并测试机器人表现
在所有模拟实验中,基模都从相对应的专家示例中训练得到,而 OOD 的鲁棒性是通过“目标和环境参数不变的情况下,对机器人初始状态施加干扰”来衡量的
真机: 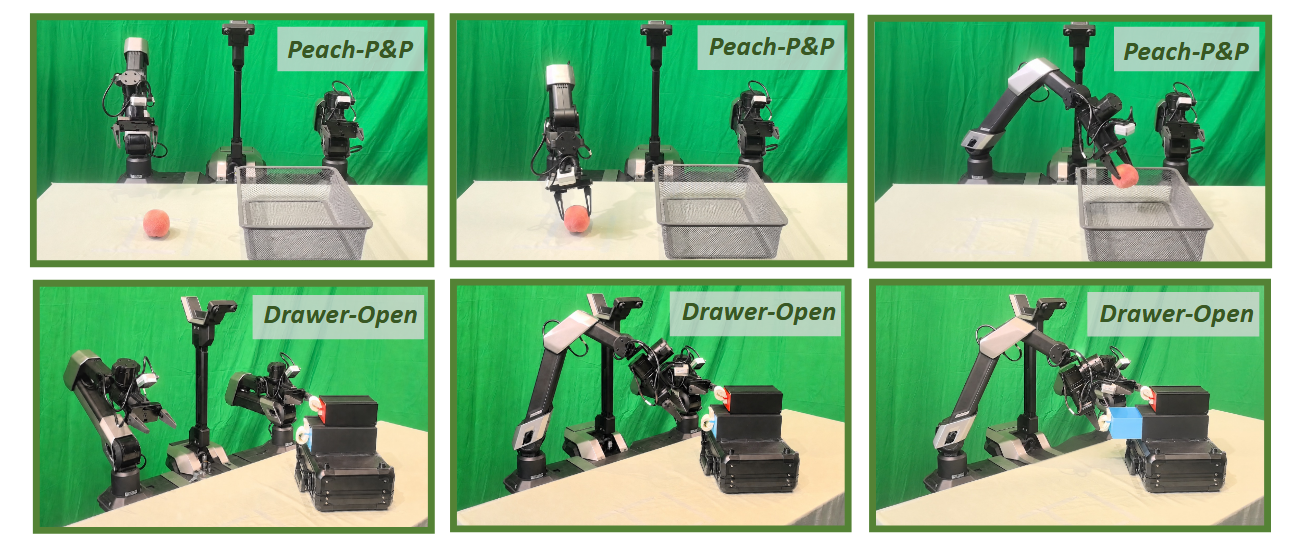
- Peach-P&P:50条专家轨迹
- Drawer-Open:65条专家轨迹
模型全都从0训练,测试时将机器人手臂设置成训练时没训练过的初始状态以衡量模型在OOD情况下的表现。
5.2 实验结果
5.2.1 Feedback world model
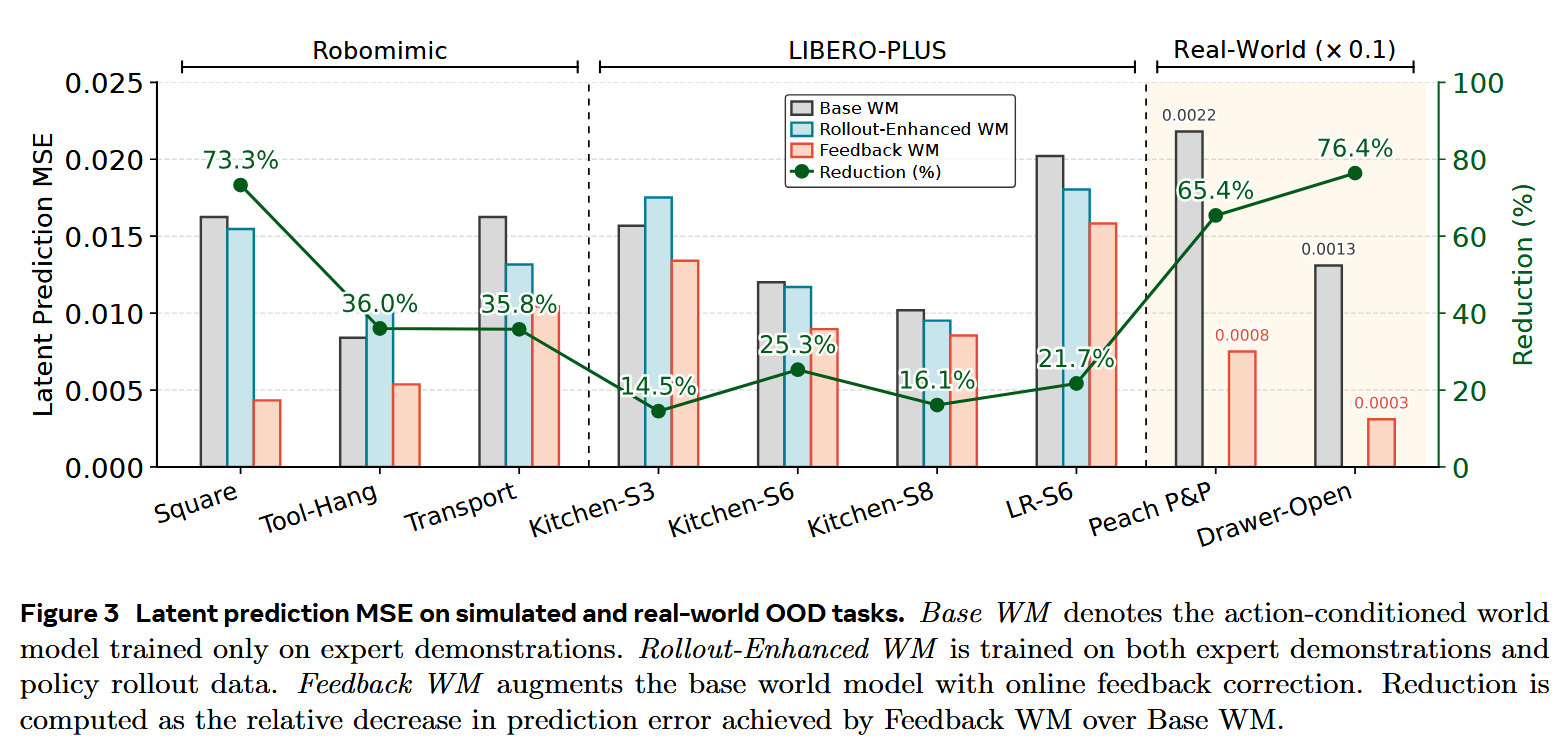 图片中展示的数据是在真机与模拟任务中,模型做出的潜空间预测的 MSE 差距:在 Robomimic Square 上误差相对降低73.3%,Peach-P&P and Drawer-Open 上分别相对降低65.4%和76.4%。其中:
- BaseWM:只使用专家示例训练的 WM
- Rollout-Enhanced WM:专家示例+rollout 数据
- Feedback WM:通过在线 feedback 修正 base WM
需要注意,图中的数据是 FeedbackWM 相较于 baseWM 的误差相对降低,绝对降低并没有很高
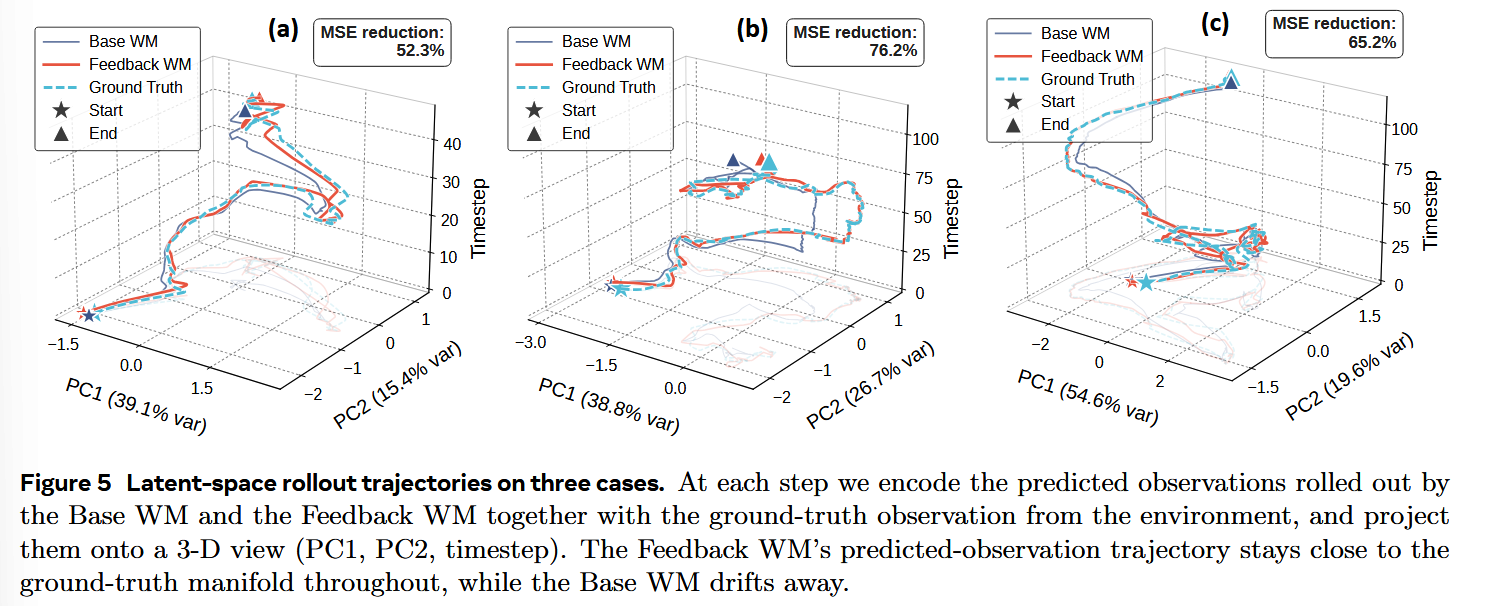 作者接着进行了主成分分析(Principle Component Analysis):将 BaseWM(深蓝色)和 FeedbackWM(红色)和 ground truth(浅蓝色虚线)的轨迹用相同方式投影,找出方差最大的两个维度,绘制它们随时间的变化。
作者声称 FeedbackWM 的轨迹始终距离 ground truth 更近.
5.2.2 Action-aware guidance
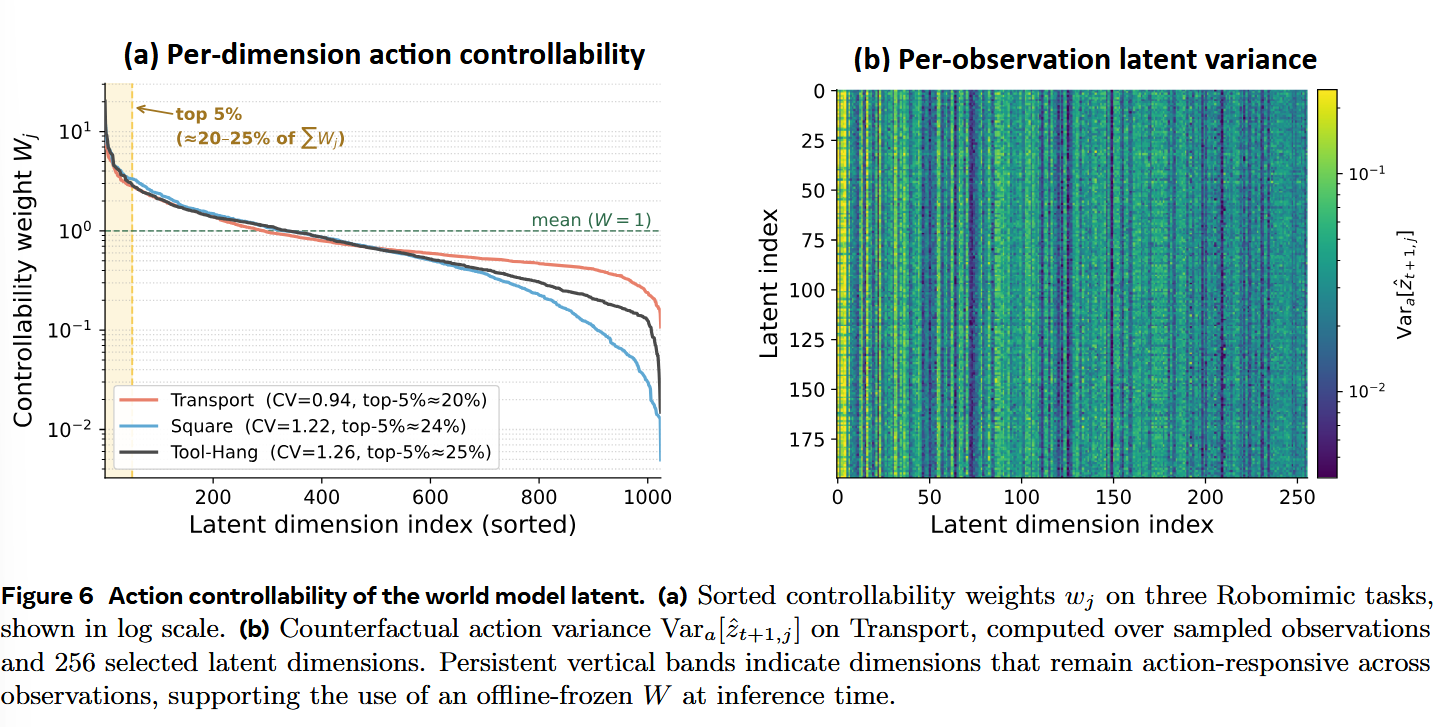 接着分析 WM 潜空间上哪些维度对 action 的影响最大,即固定当前状态\(z_t\),改变输入 WM 的 action,观察输出中每个维度的方差。 a:不同任务下,潜空间不同维度对于 action 的影响权重。实验发现:top5% 的维度贡献了20-25%的总控制权重 b:颜色越亮方差越大。可以观察到,只有少数维度对 action 变化较为敏感
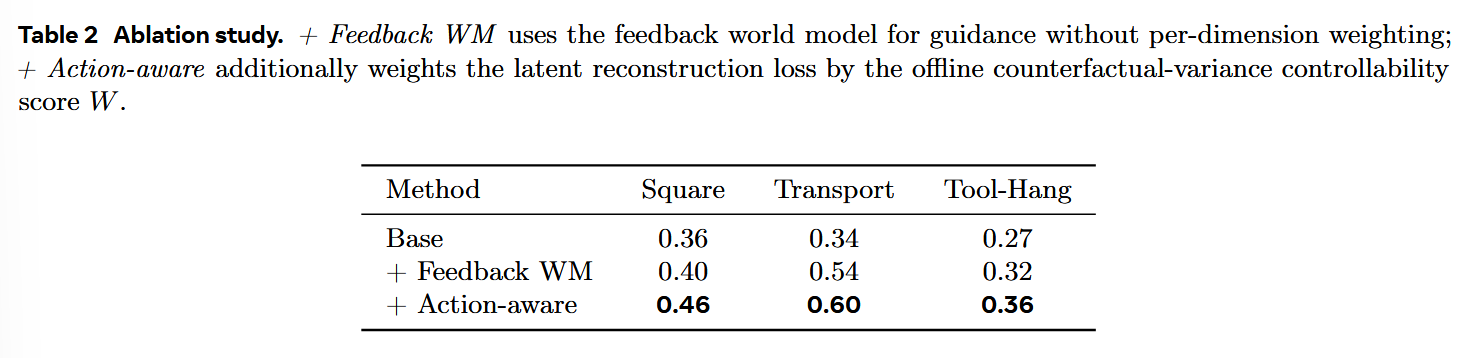 消融实验证明 Feedback 机制与调整潜空间维度权重都使成功率得到提升
5.2.3 整体表现
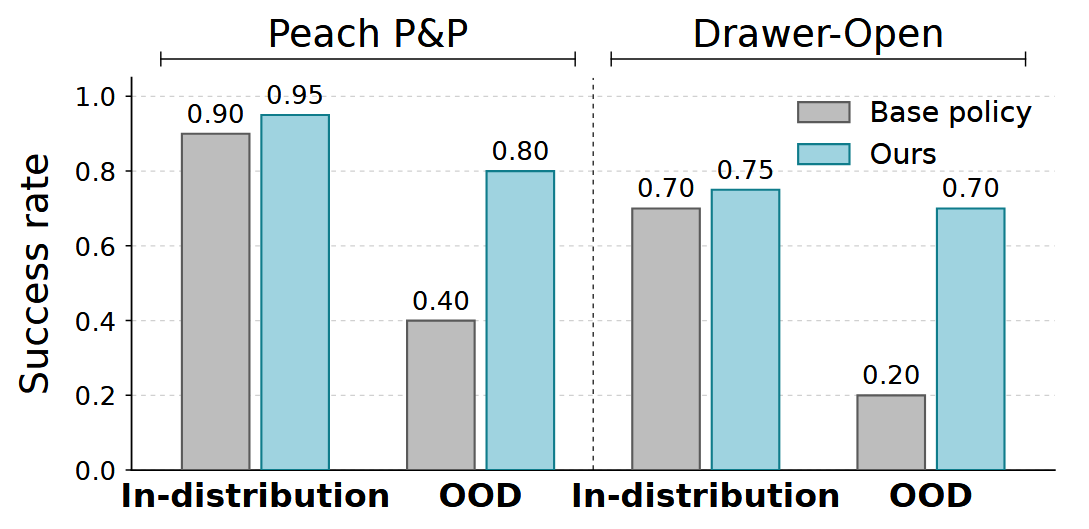 真机环境下提升非常显著:Peach P&P 在 OOD 情况下由0.40提升到0.80;Drawer-Open 从0.20提升到0.70
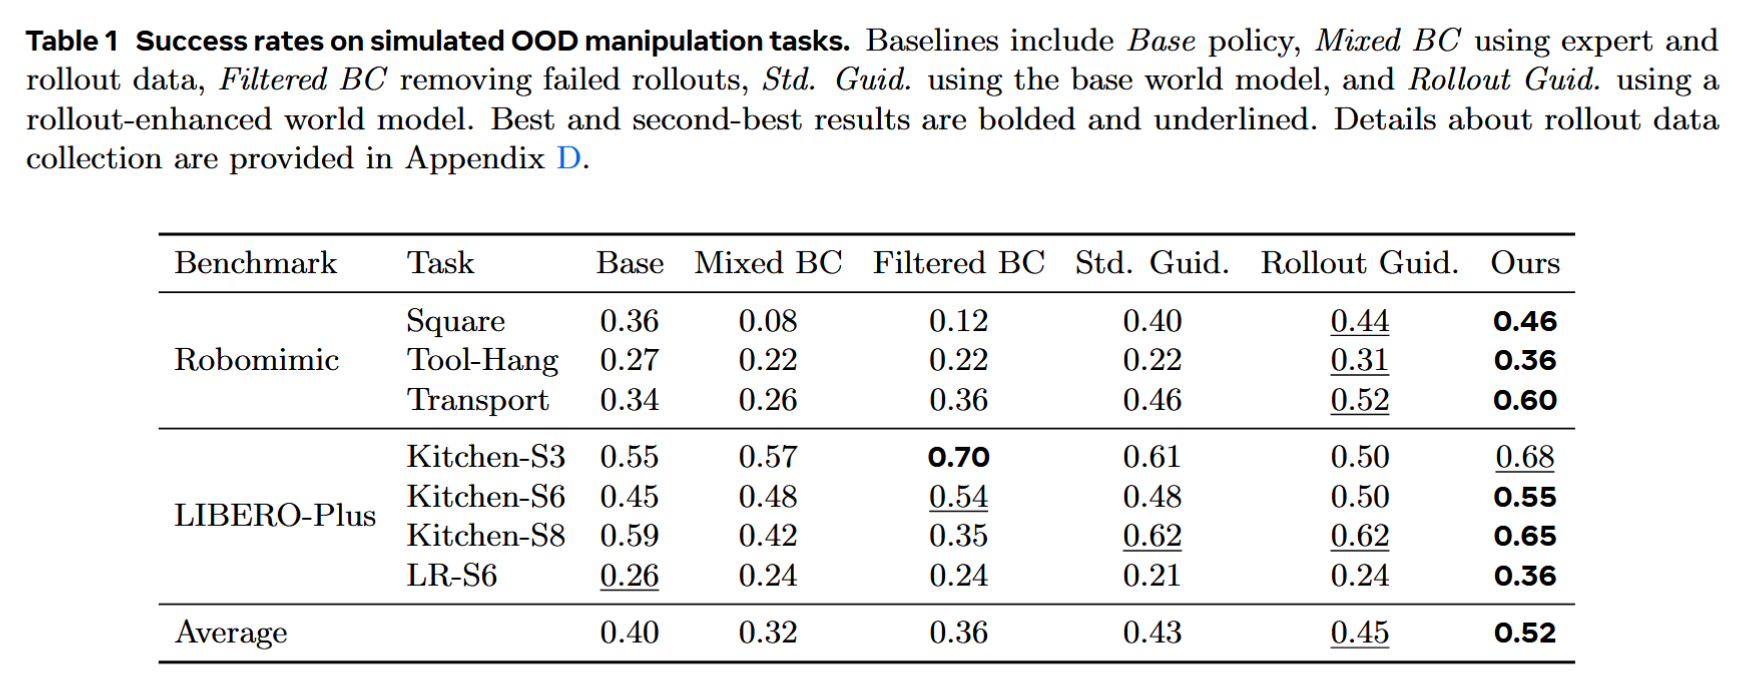 比较不同方法在模拟环境下的表现:
- Base:只用 expert 数据训练的 BC
- Mixed BC:expert 数据+模型自己 rollout 出来的轨迹
- Filtered BC:expert 数据 + rollout 中成功轨迹
- Standard. Guid:使用单纯的 WM 来引导 DP
- Rollout Guid:使用 expert 数据+全部 rollout 数据重新训练一个 WM,不使用 Feedback 进行修正
- Ours:使用 Feedback + action-aware guidance 的 WM 引导 DP
结论:单纯增加 rollout 数据并不确保提升 OOD 泛化能力,因为 rollout 轨迹中可能包含失败数据/有偏差的状态分布或收集的额外数据并没有覆盖最终测试时遇到的 OOD 状态
6、缺陷与未来工作
相较于无引导的 DP 方法,这种在推理时对 DP 进行引导的方法会带来更高的延迟。未来工作可以将这种方法应用在更高效的引导架构和对延迟要求更高的机器人任务上。
7、个人评价
文章的重点落在提升模型在长时间或者 OOD 情形下的预测表现。但作者所研究的 OOD 仅指代机器人初始状态的扰动。OOD 状态还应该包含未见到的物理状态,比如改动物体质量、形状、桌面摩擦力等。同时,长时间仅指任务执行的步数多,而不是模型一次性预测更长的步数。对于更复杂的分布漂移情形,这种单纯线性的 feedback 修正可能就不起作用了。作者的 claim 比实验证明的强很多。
II. Variational Neural Dynamics
1. Problem Formulation
将机器人建模为部分可观测的马尔可夫决策过程 POMDP(partially observed Markov decision process):\(\mathcal M=(\mathcal S,\mathcal A,\mathcal W,T,r,\gamma)\)。
- \(\mathcal S\):状态空间,指机器人本体的物理状态,包括位置、朝向、速度等
- \(\mathcal A\):机器人可能的动作序列
- \(\mathcal W\):可能的动力学状态空间
- \(T\):动力学会如何发生转移
- \(r\):回报
- \(\gamma\):衰减因子 真实状态转移受隐藏动力学条件 \(w\) 影响:\(s_{t+1}\sim T(\cdot\mid s_t,a_t,w)\)。其中 \(w\) 不可直接观测,可表示 wind、payload、friction、hardware degradation 等动力学因素。
encoder 将最近一段 state-action history \(\mathcal H_{t-C:t}\)编码得到低维 latent:\(z_t=E_\phi(\mathcal H_{t-C:t})\)。 其中 \(z_t\) 表示当前隐藏动力学条件的潜空间表示,并作为 policy 的条件输入:\(a_t=\pi_\theta(o_t,z_t)\),从而使同一 policy 能适应不同的环境。
作者使用持续学习的方式,总体上在“真实环境交互”和“用可微模型更新策略”之间不断交替进行。整个架构由两个部分构成:
- dynamics model:根据 state,action 和 latent z 预测下一时刻的 state
- policy model:根据 observation 和 latent z 预测当前的最佳动作
2. Variational Neural Dynamics Model
接着,作者将状态预测分成两部分: \[ \hat{\mathbf{s}}_{t+1} = f_{\mathrm{prior}}(\mathbf{s}_t,\mathbf{a}_t) + D_\psi(\mathbf{s}_t,\mathbf{a}_t,\mathbf{z}_t) \]
- \(f_{\mathrm{prior}}(\mathbf{s}_t,\mathbf{a}_t)\):已知的 nominal dynamics model,描述机器人已经可以解析建模的动力学。
- \(D_\psi(\mathbf{s}_t,\mathbf{a}_t,\mathbf{z}_t)\):residual dynamics model,根据当前环境的动力学条件调整\(f_{prior}\)的预测结果
训练的损失函数: \[ \mathcal{L}_{\mathrm{vnd}} = \mathcal{L}_{\mathrm{dyn}} + \lambda_{\mathrm{rec}}\mathcal{L}_{\mathrm{rec}} + \lambda_{\mathrm{mmd}}\operatorname{MMD}(q_\phi,p) \]
- dyn:模型预测与 ground truth 之间的差距
- rec:从\(z_t\)还原 state-action history,使得 encoder 能够保留更多的轨迹信息
- mmd:将 encoder 编码向量与高斯分布对齐,方便采样训练
3. Policy Learning with Sampled Latent Dynamics
前一节已经通过 MMD 将 latent distribution 对齐到标准高斯分布,因此训练 policy 模型时,可以直接从 \[ \mathbf{z}\sim p(\mathbf{z})=\mathcal{N}(\mathbf{0},\mathbf{I}) \] 中采样 z。它代表的就是某种环境的动力学特征。
对于每个 simulated rollout,采样一个 \(\mathbf{z}\) 并在整个 rollout 中保持不变。该 \(\mathbf{z}\) 同时输入 policy 和 residual dynamics: \[ \mathbf{a}_t=\pi_\theta(\mathbf{o}_t,\mathbf{z}) \] \[ \mathbf{s}_{t+1} = f_{\mathrm{prior}}(\mathbf{s}_t,\mathbf{a}_t) + D_\psi(\mathbf{s}_t,\mathbf{a}_t,\mathbf{z}) \]
训练时冻结 dynamics model,只更新 policy 参数 \(\theta\),通过最大化 reward 的方式来更新 policy 模型: \[ \max_\theta \mathbb{E}_{\mathbf{z}\sim p(\mathbf{z}),\,\mathbf{s}_0\sim\rho_0} \left[ \sum_{t=0}^{H-1} \gamma^t r(\mathbf{s}_t,\mathbf{a}_t,\mathbf{s}_{t+1}) \right] \] 其中,reward 由作者人工定义,\(a_t\)从 policy model 中获得,\(s_t\)同样受到\(a_t\)的影响。
4 实验
4.1 模型是否真的抓住了隐藏的物理学变量
即使没有显式建模风向和风力,模型依然能将不同的风区分开 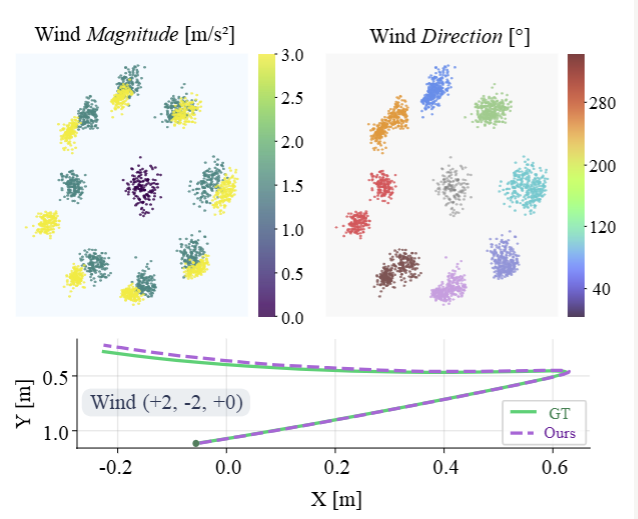 上面两个散点图中,每个点代表模型预测的一个动力学向量在平面上的投影。作者分别改变风力和风向多次测试,可以发现这些点形成了分布明确的聚簇。 下面的曲线图则是给定同一个风时,模型预测与 ground truth 之间的差异,证明模型效果好。