论文阅读——HandWorld
本文最后更新于 2026年10月13日 09:30:36
三. Method
3.1 生成模型的训练目标
定义损失函数:让 action 序列\({}A_{0:T}{}\)和压缩到潜空间的 video 序列\({}Z_{0:T}{}\)的联合概率最大化。 假设马尔可夫性质:生成对象只与过去 m 个状态有关,将\({}A_{t-m+1:t}{}\)和\({}Z_{t-m+1:t}{}\)作为上下文 encode 得到\({}C_{t}{}\)作为 flow matching 生成过程中的额外条件。
实际训练时,负对数似然损失转换成了 action 和 video 两个分支的 flow matching 损失。因此,这个 C 同时承担了压缩过去历史和对齐两个分支的作用,从而让两个 DiT 可以解耦。
3.2 跨领域的表征 C
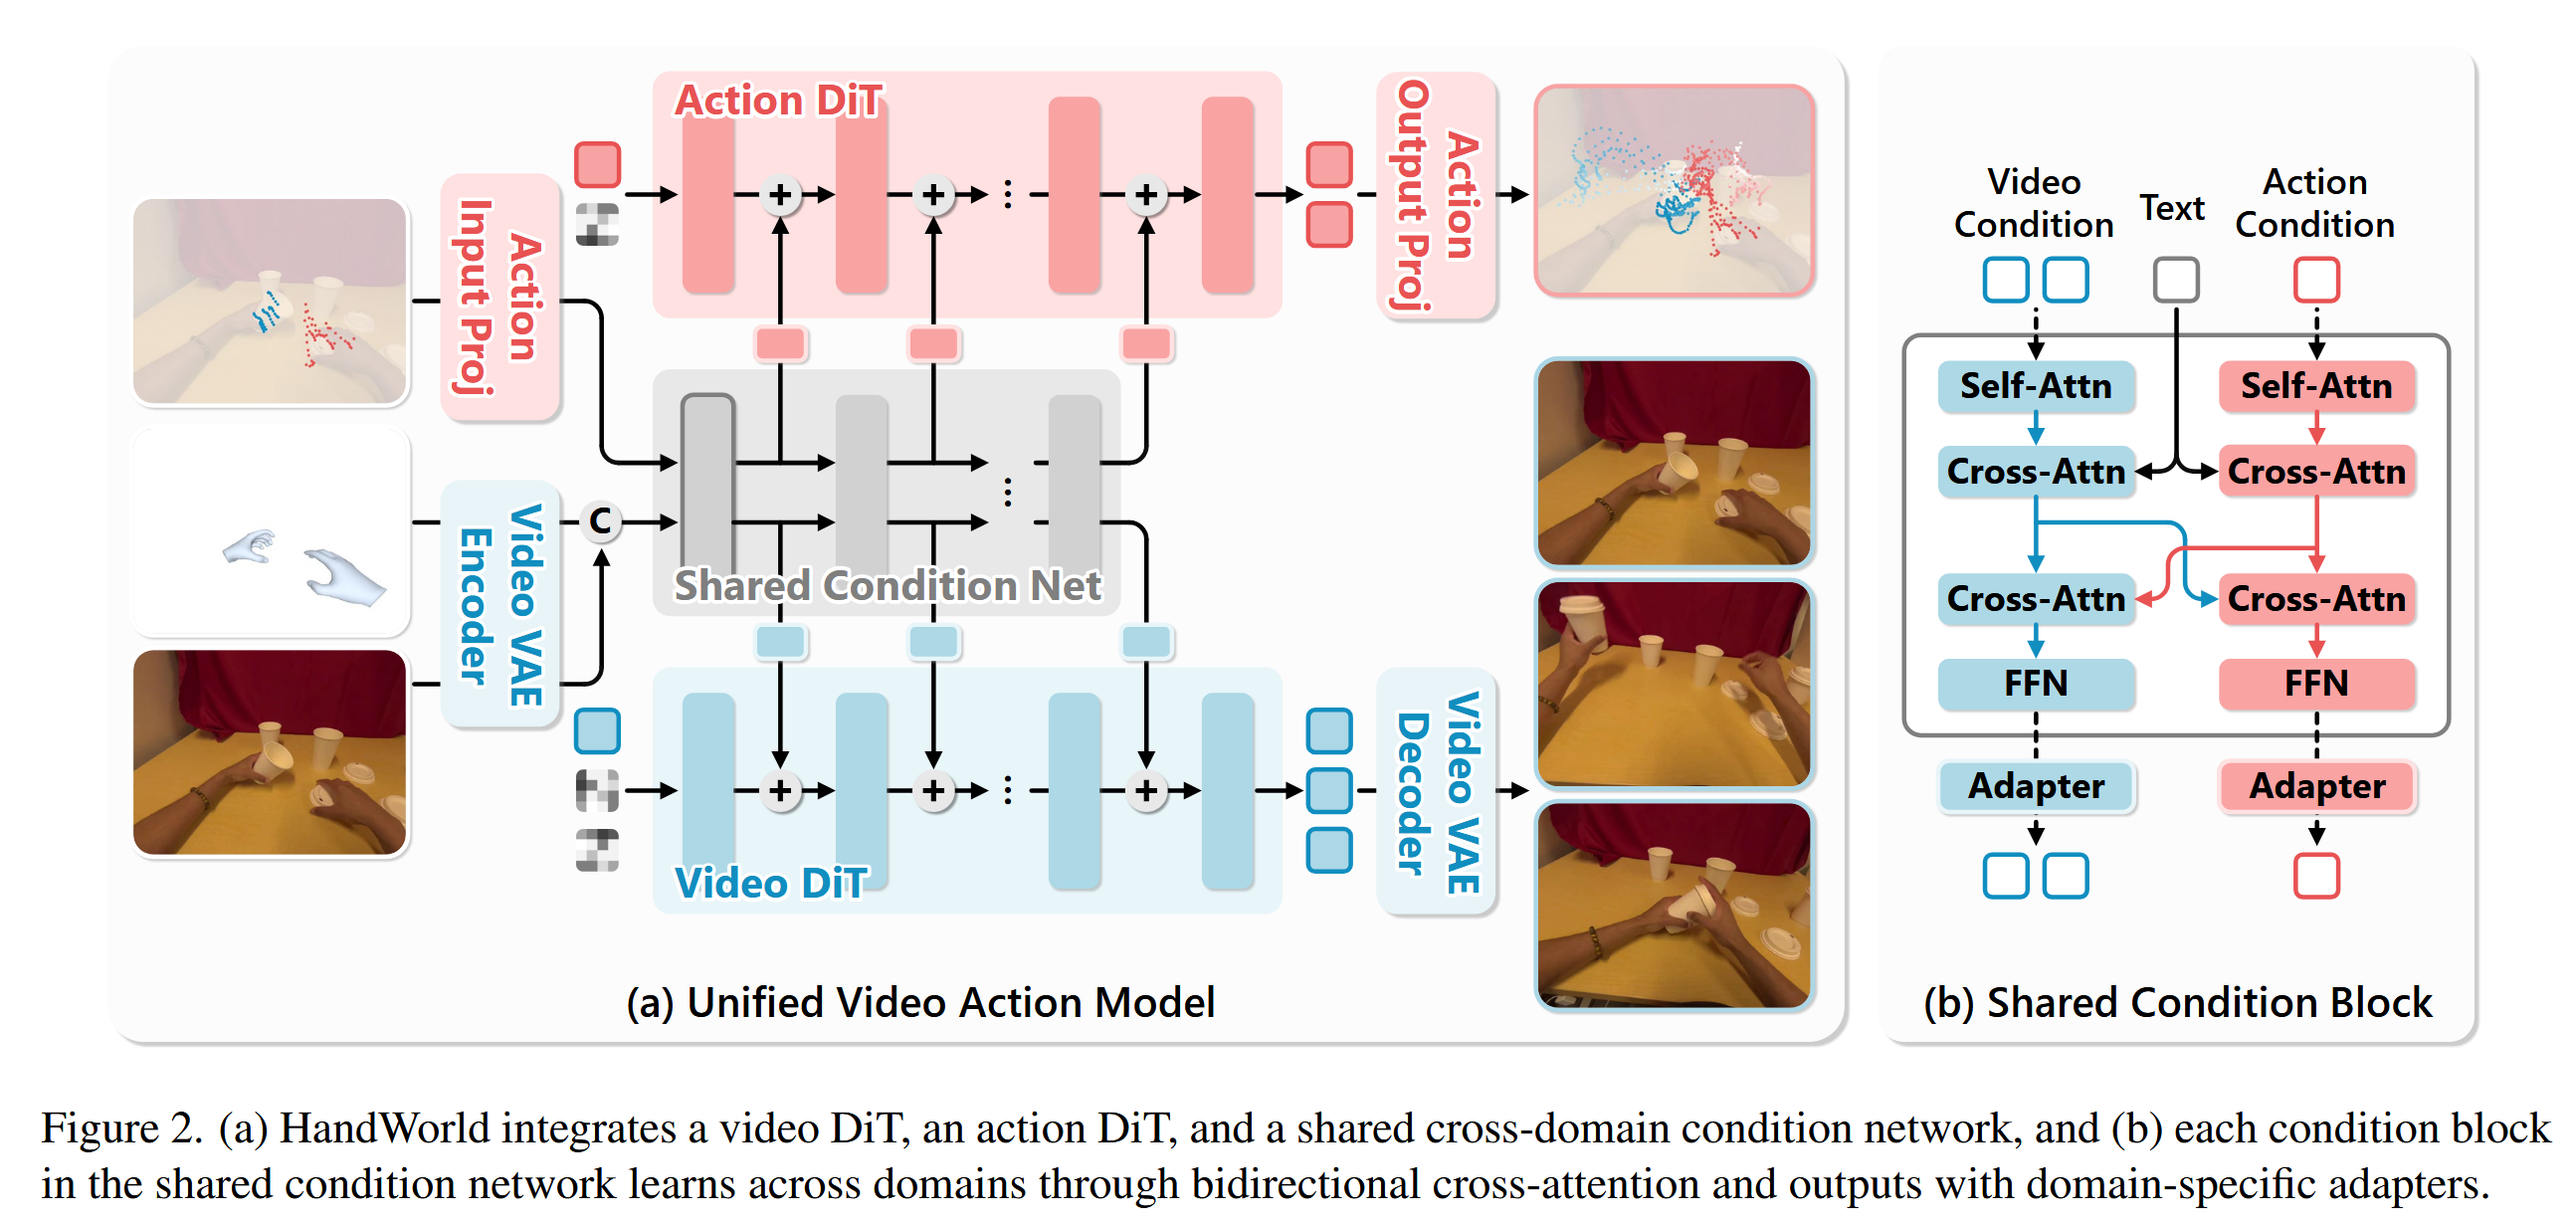 Shared Condition Net 同时处理视频和动作,其中视频包含 latent video+MANO,因此视频的方块数量为两个;而动作只包含动作本身,因此方块数量为一个。
condition net 的每一层都是一个 condition block,通过 self attention+text cross attention+dual-branch cross-attention+FFN 的方式产生当前层的 condition,再通过线性 adapter 适配 DiT,最后直接加到 DiT 对应层的输出上。因此 condition net 的层数与 DiT 一一对应。
action 和 video 都单独使用一个 DiT 进行 flow matching 生成。
这里 video DiT 为什么有两个带噪声的方块?MANO 应该不是生成对象
额外使用 MANO 作为中介:MANO 来自视觉,却在几何上与 action 对齐的特点。它具有物理信息,在实验中证明了效果更好。
理论上输入 condition network 的视频和动作应该都是序列?
3.3 适配不同目标
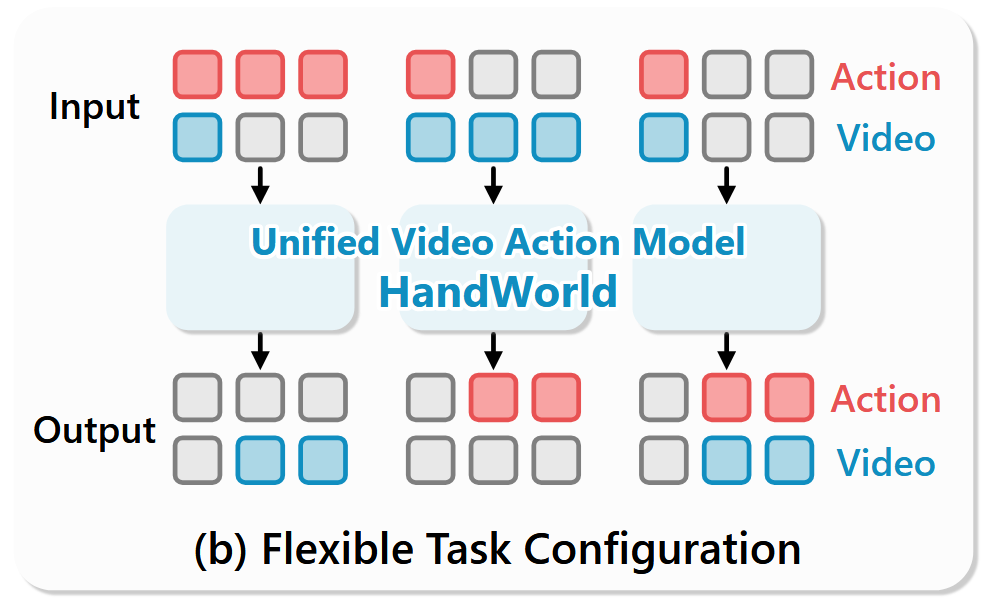 网络需要根据视频和动作输入来学会三种不同的生成模式:根据 action/video 哪个未来状态未知来决定生成哪个分支。推理时根据需要,只加载对应的 DiT,但 condition network 在不同任务中都加载。训练时同样根据加载的 DiT 分支监督模型训练,但 condition network 通过可学习的 mask token代表不可用信息进行跨任务优化。
四. Experiments
数据集:EgoDex。
- video VAE, text tokenizer, text encoder, video diffusion transformer,condition network 的 video 部分:从 Wan2.2-TI2V-5B 初始化
- adapter 层零初始化。
- 其余部分(action DiT、condition net 的 action 分支):随机初始化的。
4.1 视频生成
指标
PSNR: 比较生成图与 GT 的像素误差。
假设真实图像是 \(I\),生成图像是 \(\hat I\): \[ \mathrm{MSE} = \frac{1}{HWC} \sum_{i=1}^{H} \sum_{j=1}^{W} \sum_{c=1}^{C} (I_{ijc}-\hat I_{ijc})^2 \] \[ \mathrm{PSNR} = 10\log_{10} \frac{MAX_I^2}{\mathrm{MSE}} \]其中 \(MAX_I\) 是像素能达到的最大值。 缺点:不理解图像内容,只看像素有没有对上。
SSIM: 比较局部视觉结构是否一致。
比较:- 亮度:平均值是否接近;
- 对比度:像素变化幅度是否接近;
- 结构:像素之间的变化关系是否接近。
LPIPS: 比较 CNN 多层视觉特征的感知相似性。
CLIP: 比较高层语义相似性。
CLIPhand:针对手部区域。FVD: 比较整段视频的视觉与时序一致性。
送入同一个预训练好的视频网络,得到特征集合,用高斯分布近似后比较两个分布之间的 Fréchet distance: \[ \mathrm{FVD} = \|\mu_r-\mu_g\|_2^2 + \mathrm{Tr} \left( \Sigma_r+\Sigma_g - 2(\Sigma_r\Sigma_g)^{1/2} \right) \]IoU: 比较手生成的位置是否准确。
Intersection over Union,比较两个区域重叠得有多好。
实验结果
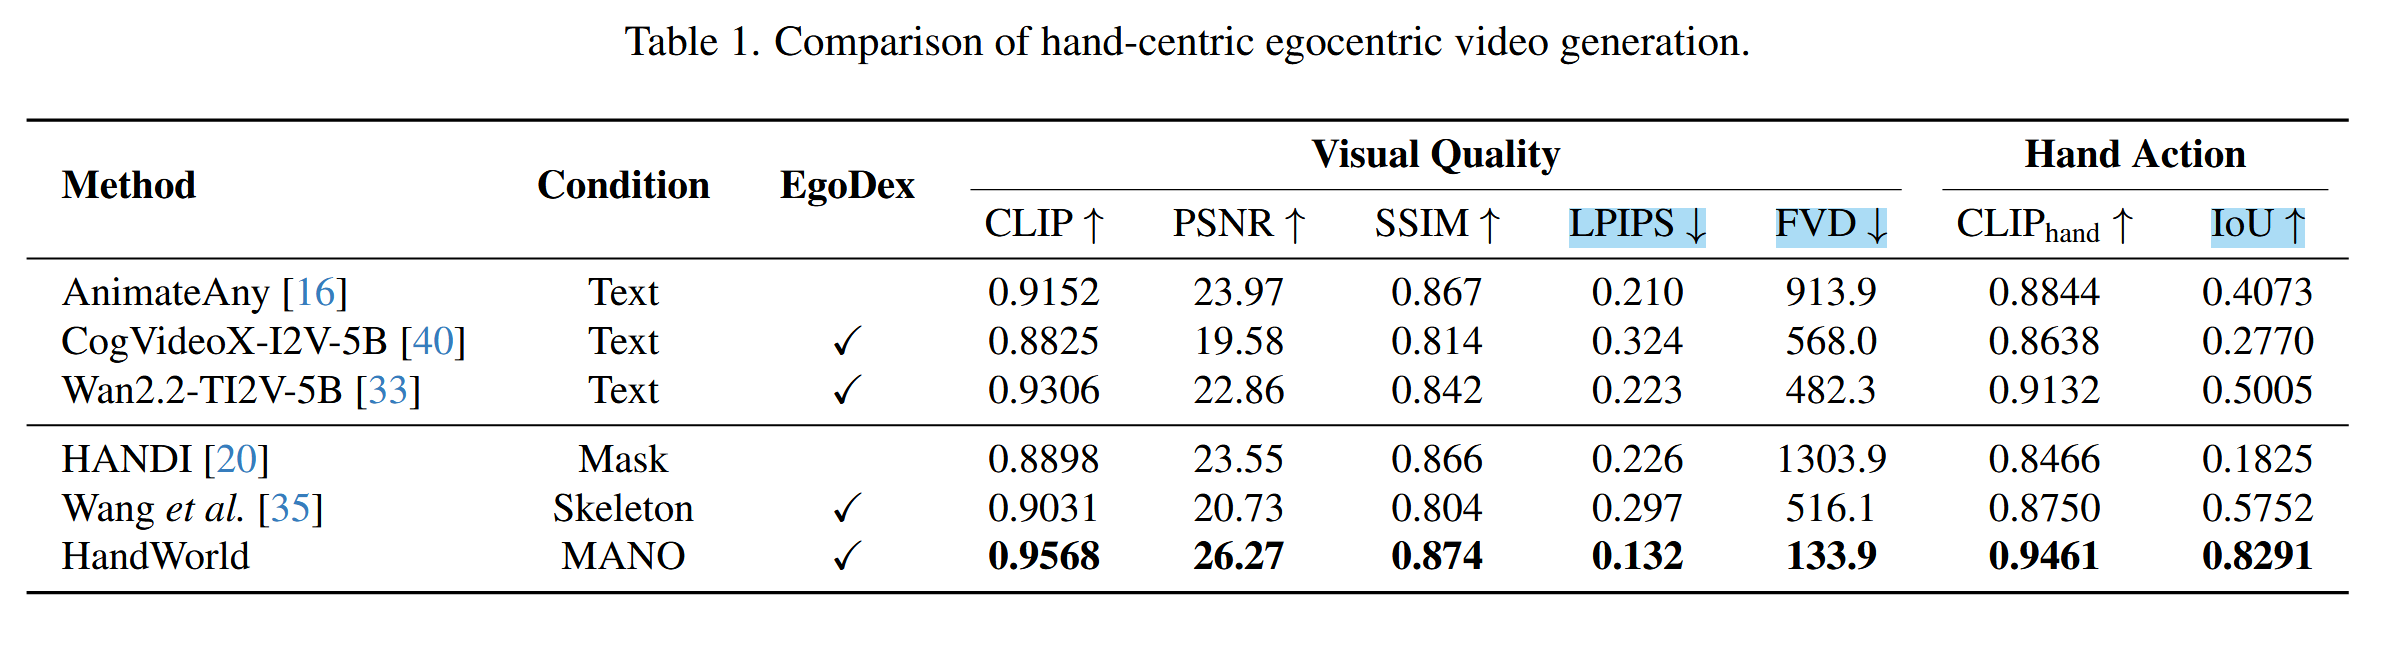 HandWorld 采用基于物理的控制信号(MANO),结果更自然、精细、与环境更加一致
- 相较于纯视频生成模型,FVD 展示了其更强的真实感和时间连贯性,而更高的 CLIP 和 SSIM 分数证实了其增强的感知质量。
- region-based(HANDI):缺乏精确的结构约束,导致手部姿势和轨迹不一致。
- Wang 等人采用基于骨架的视觉提示来改善粗略的运动对齐,但不能完全捕捉手指的细微变形。
4.2 动作预测
指标:best-of-K
每个样本生成 K 个预测,将这 K 个中与 gt 距离最近的作为结果
实验结果 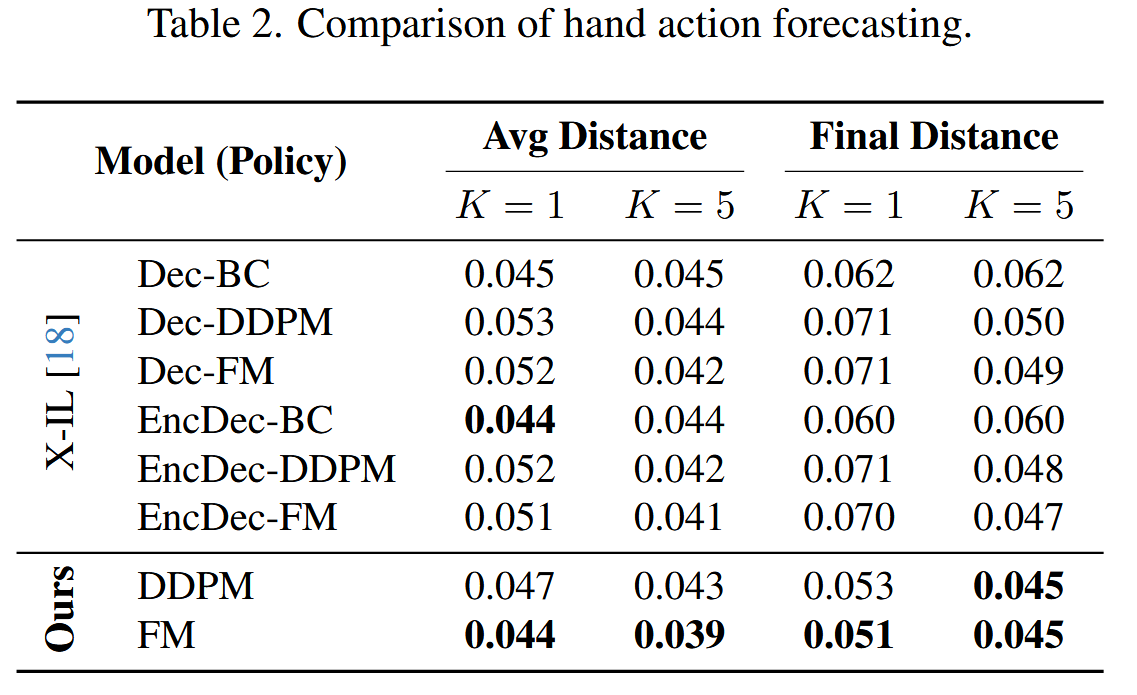
4.3 消融实验
实验结果 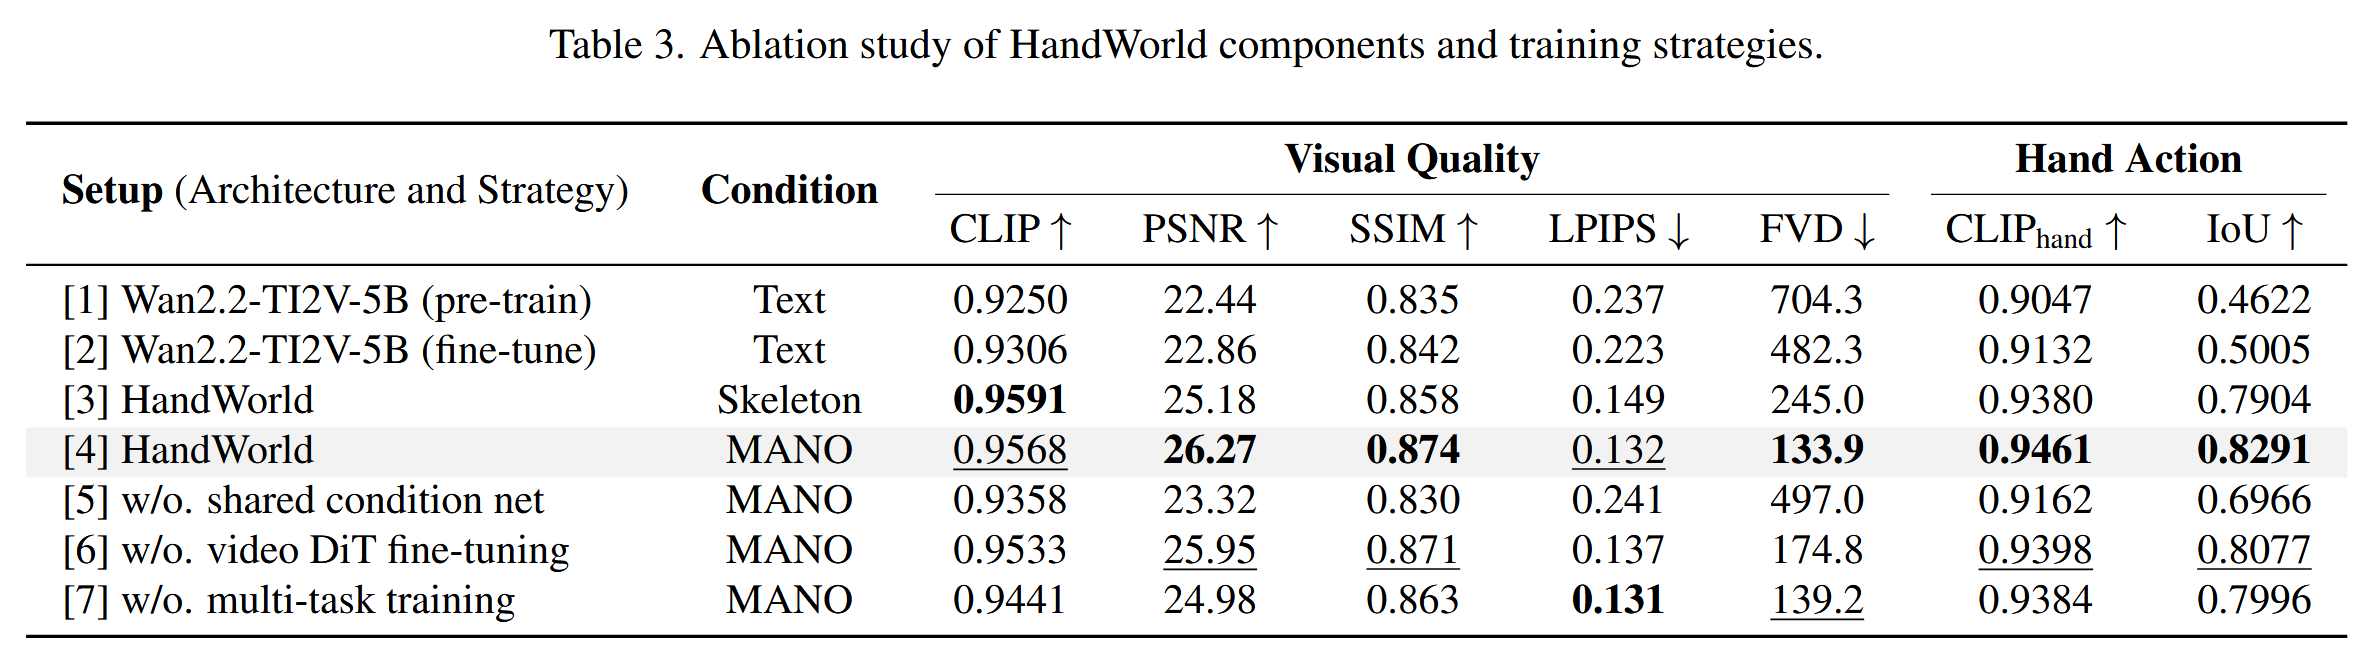 实验结论:
- 单纯的以文本作为条件:无法有效控制手部动作
- 以骨骼作为条件:粗糙,手部物理细节不够合理
- 单纯使用 ControlNet 作为 MANO 条件注入:在两个领域的一致性不如 shared condition
- 视频模型在数据集上 fine-tune 很重要,尽管会带来额外开销
- 跨任务优化进一步提升了两个领域的耦合