论文阅读——FeedbackWM
本文最后更新于 2026年9月26日 11:37:54
3.2 DP
\[ s_\phi\left(A_t^{(\tau)}, O_t, \ell, \tau\right) \approx \nabla_{A_t^{(\tau)}} \log p_\tau\left(A_t^{(\tau)} \mid O_t, \ell\right), \] 其中,\(A_t^{(\tau)}\) 表示第 \(\tau\) 个去噪步的候选动作序列,\(O_t\) 为当前观测,\(\ell\) 为可选的语言指令,\(p_\tau\) 表示对应噪声水平下的条件动作概率密度分布。
Score Function 描述了当前动作序列在条件概率分布下,对数概率密度增长最快的方向。 因此,DP 可以利用学习到的 Score,逐步将初始随机噪声转化为符合当前观测与任务条件的动作序列。
由此引出了通过修改 Score 来引导动作生成的方法:
\[ \tilde{s}\left(A_t^{(\tau)}, O_t, \ell, \tau\right) = s_\phi\left(A_t^{(\tau)}, O_t, \ell, \tau\right) + \lambda g\left(A_t^{(\tau)}, O_t\right) \]
其中,\(g\) 为任务导向的指导项(Guidance Term),\(\lambda\) 为指导强度。通过在原始 Score 中引入额外的指导方向,可以在保留 DP 原有动作分布先验的同时,使生成的动作更加符合额外的任务目标或约束。
4 方法
4.1总览
将obs、proprio编码进潜空间后得到\(z\)。将专家示范中的观测编码为 expert latent 集合 \(Z^E=\{z_i^E\}_{i=1}^{N}\)。对于当前候选动作序列,使用世界模型预测下一时刻 latent,并在 \(Z^E\) 中检索距离最近的 expert latent。 \[ A_t^{(\tau)} \] 表示:在环境时间步 \(t\),扩散去噪进行到第 \(\tau\) 步时的候选动作序列。 \[ i^* = \arg\min_i \left\| \hat{z}_{t+1}\left(A_t^{(\tau)}\right) - z_i^E \right\|_2^2 \] 之后再计算距离最近的这个点的距离,当作指导能量 \[ E\left(A_t^{(\tau)}\right) = \left\| \hat{z}_{t+1}\left(A_t^{(\tau)}\right) - z_{i^*}^{E} \right\|_2^2 \] 最后用偏导来影响DP的打分 \[ \tilde{s} = s_\phi - \lambda \nabla_{A_t^{(\tau)}} E\left(A_t^{(\tau)}\right) \] 作者提到这种方程有两条限制:
- distribution shift:推理时的数据没见过,且预测误差会随着时间累积
- 标准mse中每个维度是相同的。但潜空间中与action有关的维度应该被赋予更高的权重,其他的应该过滤掉
4.2 FeedbackWM
作者基于自己之前的研究FEEDBACK FAVORS THE GENERALIZATION OF NEURAL ODES,提出用当前obs和当前pred之差来修正预测速度,并用速度修正z,从而缩小与obs之间的差距。
这个反馈系统只负责obs和pred之间的差距比较小,并没有处理energy
其中\(\hat z_{t+1}\)是预测,\(z_t\)是真实观测,\(\bar z_t\)是feedback state,也就是说每次在真实观测上预测,用修正后的速度走出来的路径是feedback,根据feedback和真实观测之间的差距来修正下一次的预测。
\(A_t^{(\tau)}\)是去噪过程中,\(\tau\)的状态,用4.1中的公式进行去噪,最终只有\(A_t^0\)会被执行 \(\bar{z}\)是feedback state \[ v_t\left(A_t^{(\tau)}\right) \triangleq \frac{ f_\theta\left(z_t, A_t^{(\tau)}\right)-z_t }{ \delta t } = \frac{ \hat{z}_{t+1}-z_t }{ \delta t } \] \[ e_t = z_t - \bar{z}_t \] \[ \begin{cases} \hat{v}_t\left(A_t^{(\tau)}\right) = v_t\left(A_t^{(\tau)}\right)+Le_t,\\[4pt] z_{t+1}^{\mathrm{fb}}\left(A_t^{(\tau)}\right) = z_t+\delta t\cdot \hat{v}_t\left(A_t^{(\tau)}\right), \end{cases} \] 这里的L是预先定义好的正数。 #TODO 这可能不是一件好事,因为修正并非是线性的,obs和pred之间的距离在不断的修正过程中是在缩小的,或许可以用注意力机制来修正,但计算量和延迟也会增加
之后根据纠正后的速度修改feedback \[ \bar{z}_{t+1} = \bar{z}_t + \delta t \cdot \hat{v}_t\left(A_t^{(0)}\right) \] \[ e_{t+1} = z_{t+1} - \bar{z}_{t+1} \]
4.3 筛选与action相关的指导项
首先筛选出对于action影响比较大的那些维度,作者的处理是固定同一个 latent state,给 WM 输入多个示例action,观察下一状态各 latent 维度随 action 改变产生的 counterfactual variance;方差越大的维度被认为越受 action 控制。这可以预处理。 \[ w_j = \frac{1}{M} \sum_{i=1}^{M} \operatorname{Var}_{a \sim \mathcal{A}_{\mathrm{demo}}} \left( \left[f_\theta(z_i,a)\right]_j \right), \qquad j \in \{1,\ldots,D\} \] 之后加权平均,用\(\beta\)来控制影响程度 \[ \bar{w}_j = \frac{w_j}{ \frac{1}{D}\sum_{k=1}^{D} w_k + \epsilon }, \qquad w_j^{(\beta)} = 1+\beta\left(\bar{w}_j-1\right) \] 最终用处理后的权重来计算energy \[ E_{\mathrm{ctrl}}\left(A_t^{(\tau)}\right) = \sum_{j=1}^{D} w_j^{(\beta)} \left( z_{t+1,j}^{\mathrm{fb}}\left(A_t^{(\tau)}\right) - \hat{z}_{i^*,j}^{E} \right)^2 \]
5. 实验
回答两个问题:
- FeedbackWM能不能在线地减少OOD情况下的预测错误
- 作者发明的这个指导项能不能进一步提升DP在OOD情形下的成功率 文章弱点: 作者所研究的OOD仅指代机器人初始状态的扰动,并不是实验过程中一直施加干扰,且所选择的初始状态干扰仅占所有OOD情况的很小一部分
5.1 环境部署
模拟:
- Robomimic(Square, Tool-Hang, and Transport),仅使用官方示例的20%数据进行训练
- LIBERO-Plus(four single-task settings from the Kitchen and Living Room (LR) scenes, focusing on the official robot initial-state perturbation category.)
LIBERO-Plus是在原始 LIBERO 上系统地制造受控 distribution shift,并测试机器人表现
在所有模拟实验中,基模都从相对应的专家示例中训练得到,而OOD的鲁棒性是通过“目标和环境参数不变的情况下,对机器人初始状态施加干扰”来衡量的
真机:
- Peach-P&P:50条专家轨迹
- Drawer-Open:65条专家轨迹 全都从0训练 测试时将机器人手臂设置成训练时没训练过的初始状态
5.2 实验结果
5.2.1 feedback机制
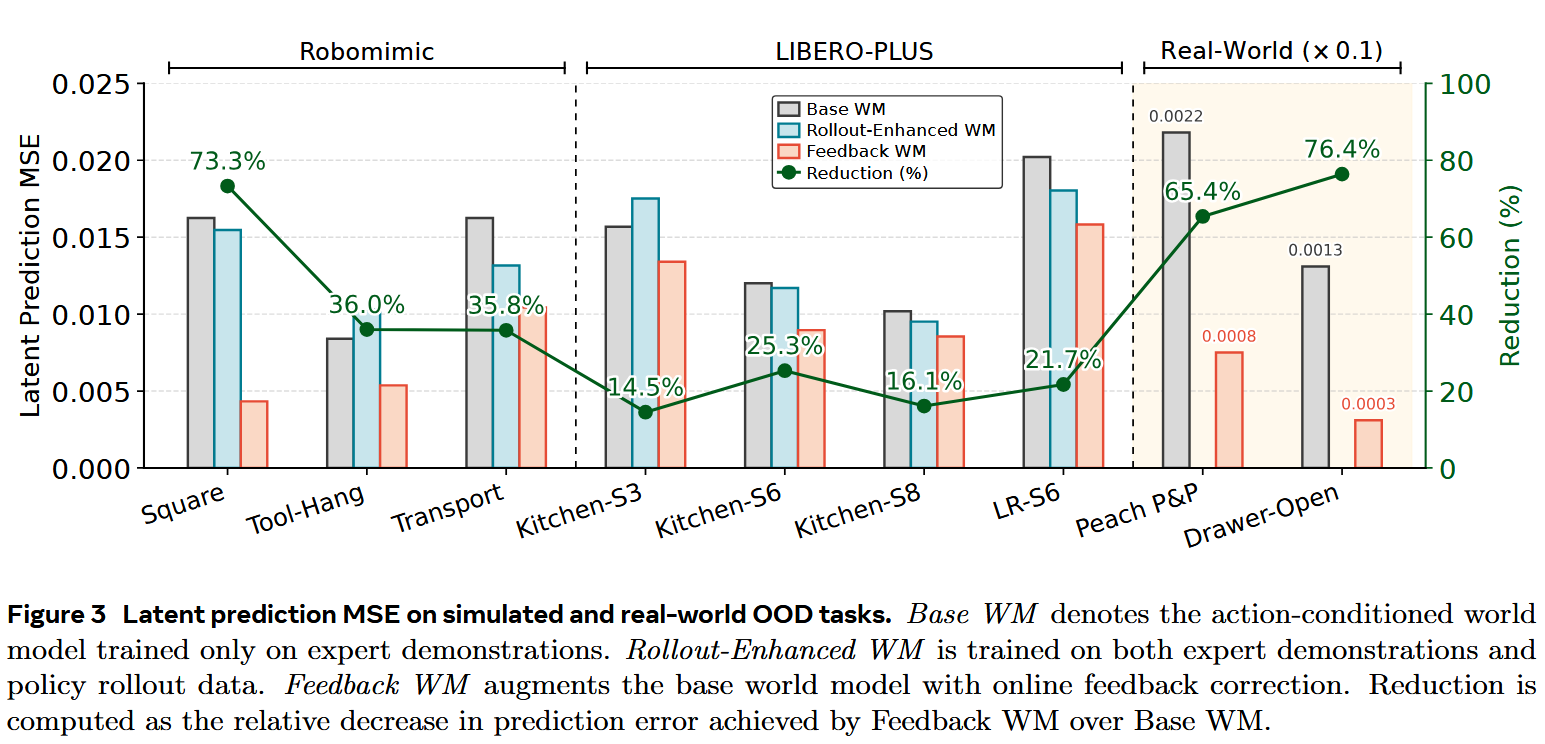
- BaseWM:只使用专家示例训练的WM
- Rollout-Enhanced WM:专家示例+rollout数据
- Feedback WM:通过在线feedback修正base WM
reduction是Feedback相较于base的误差相对降低,最高提升约70%
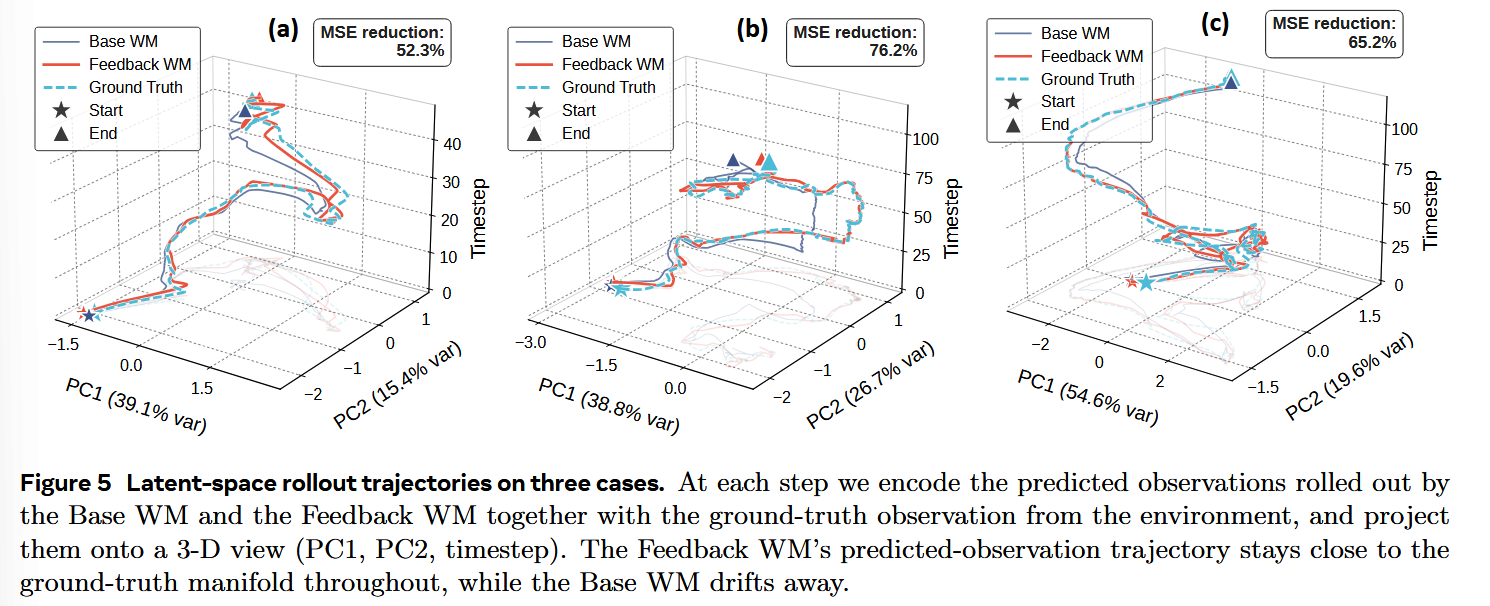 PCA结果看上去没有作者声明的那么强
5.2.2 weight
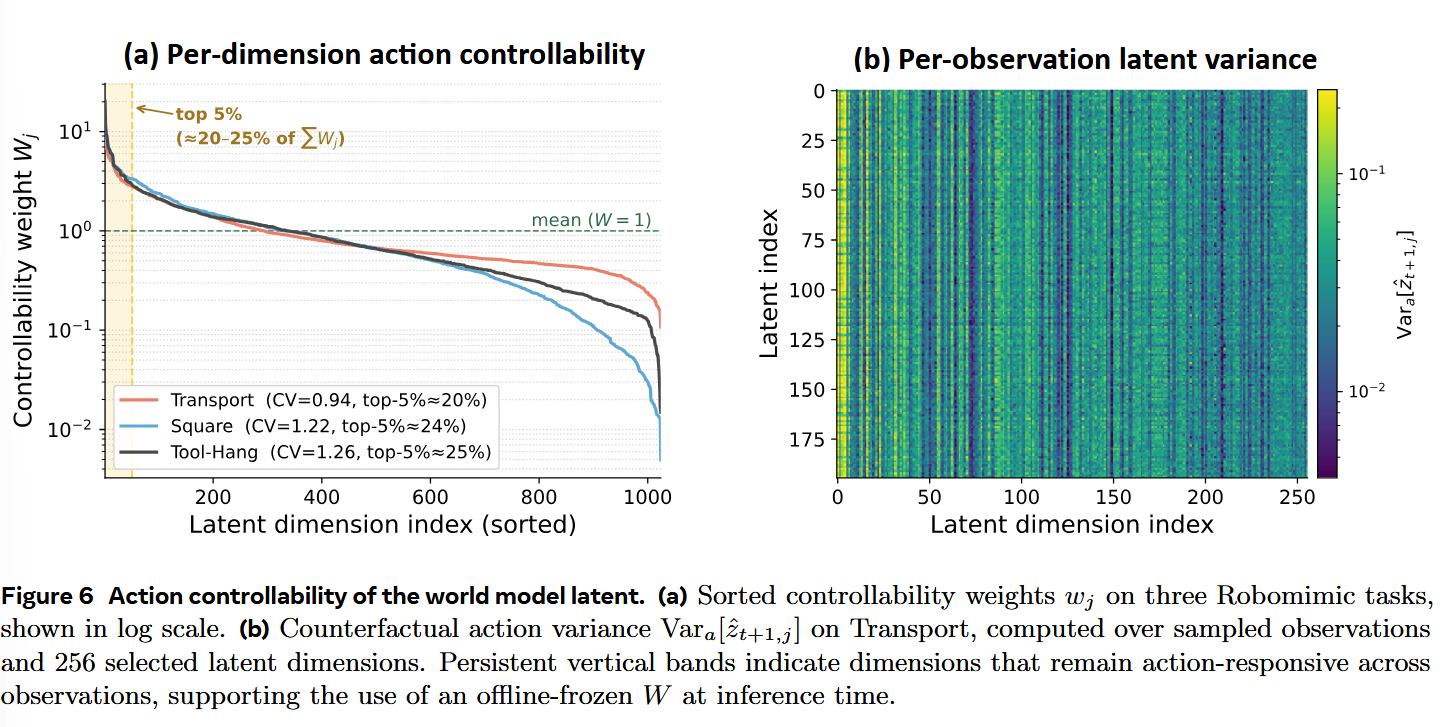 a:top5%的维度贡献了20-25%的总控制权重 b:颜色越亮方差越大,横轴是不同的latent,纵轴是dimension
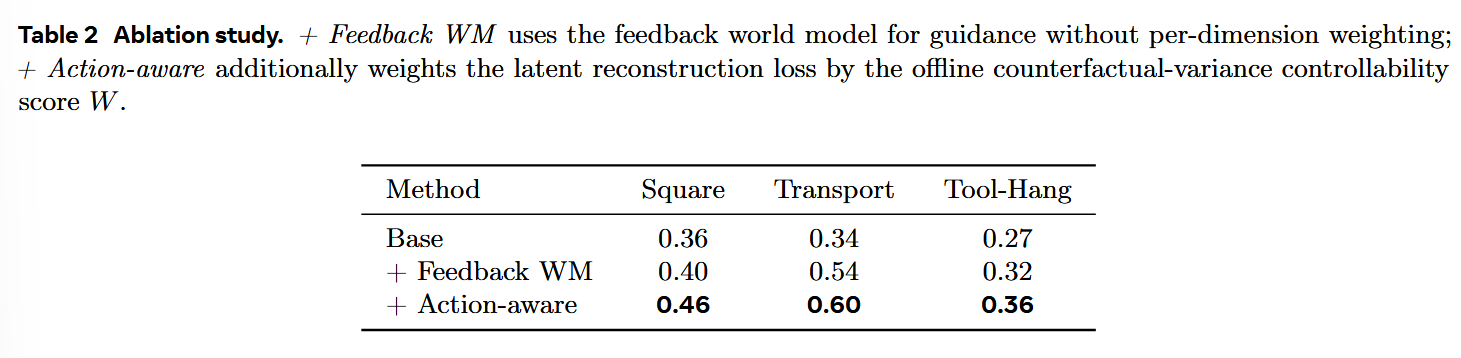 成功率进一步提升
5.2.3 合在一起
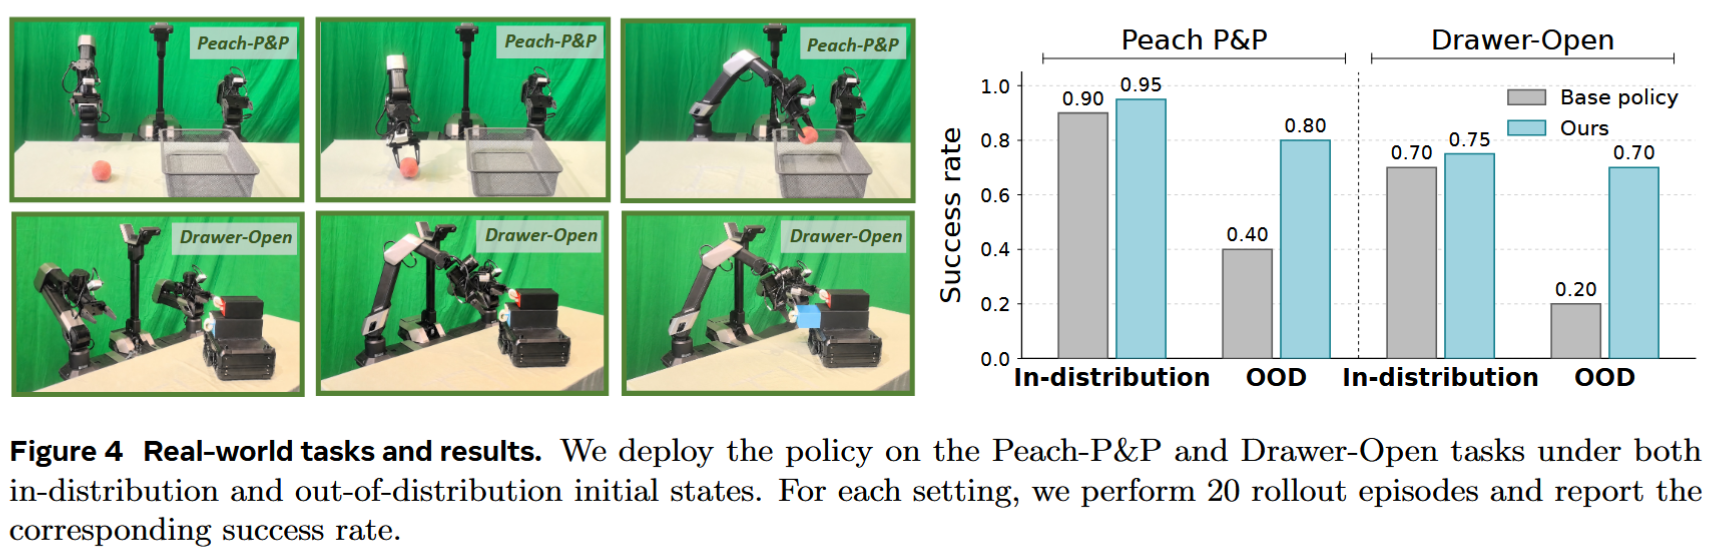 真机环境下提升非常显著:Peach P&P在OOD情况下由0.40提升到0.80;Drawer-Open从0.20提升到0.70
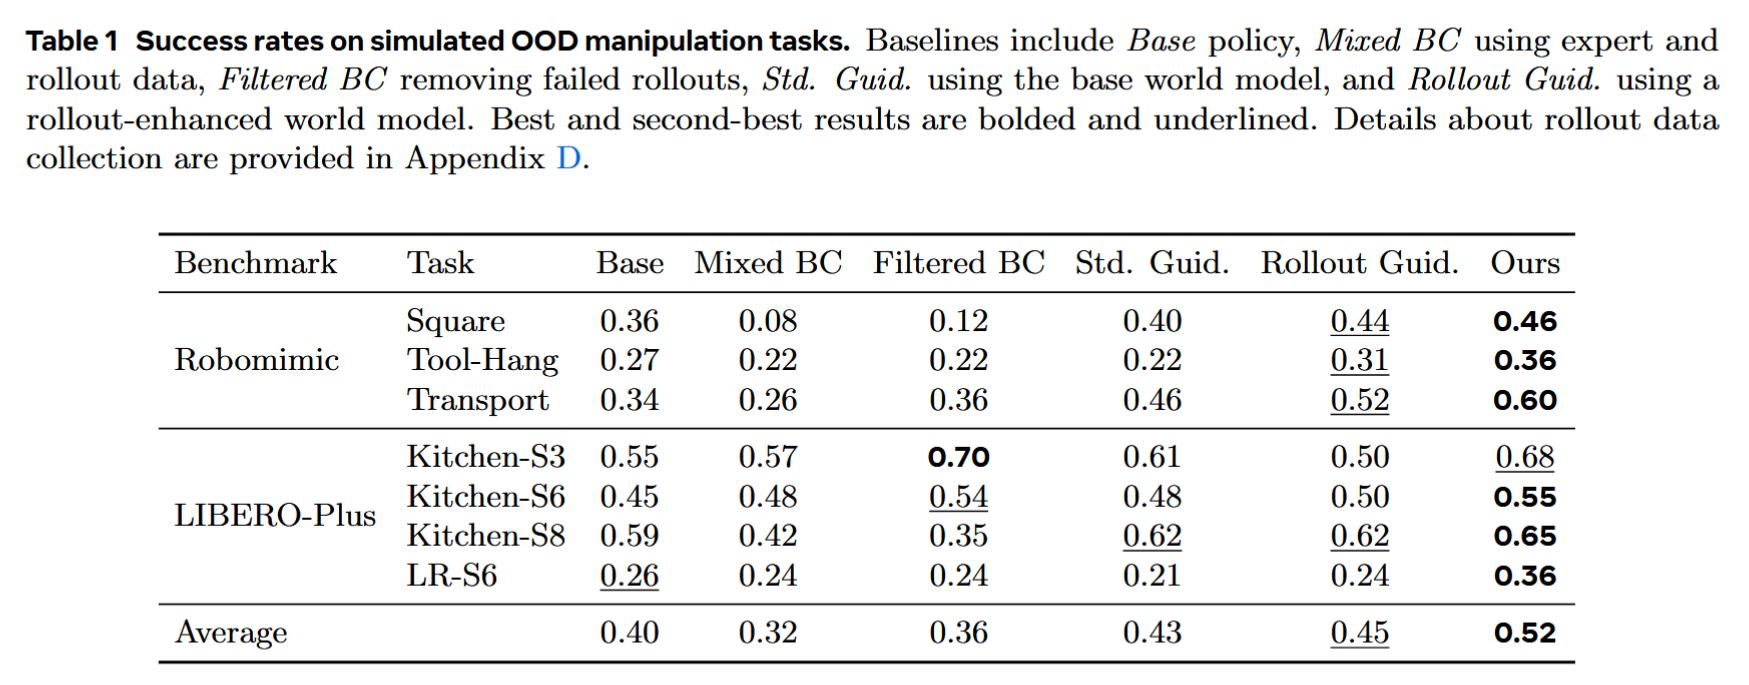 比较不同方法在模拟环境下的表现。 Base:只用expert数据训练出来的结果 Mixed BC:expert数据+模型自己rollout出来的轨迹 Filtered BC:从Mixed中筛去自己rollout中失败的轨迹 Std. Guid:不使用Feedback进行修正 Rollout Guid:使用expert数据+全部rollout数据重新训练一个WM,不使用Feedback进行修正 作者总结:单纯增加rollout数据并不确保提升OOD泛化能力,因为rollout轨迹中可能包含失败数据/有偏差的状态分布或收集的额外数据并没有覆盖最终测试时遇到的OOD状态 但单纯看模拟数据,提升并不明显
Appendix
1. 理论收敛保证。
作者证明 feedback residual 满足类似: \[ e_{t+1} = (I - \delta t L)e_t + \delta t \Delta_t \] 如果系统稳定,则: \[ \lim_{t \to \infty} \|z_t - \bar{z}_t\| \le \frac{\gamma}{\lambda_{\min}(L)} \] 这是feedbackWM的理论依据,即通过修正,最终结果与gt的差距不会超过某一特定范围
2. 具体实施细节
作者只在最后的\(\tau_g\)个低噪去噪步骤中使用feedback,其余仍然使用默认的DP。这是因为高噪情况下action尚未形成有意义的task structure