论文阅读——VND
本文最后更新于 2026年9月26日 11:34:00
Continual Robot Policy Learning via Variational Neural Dynamics,arxiv preprint
3. Methodology
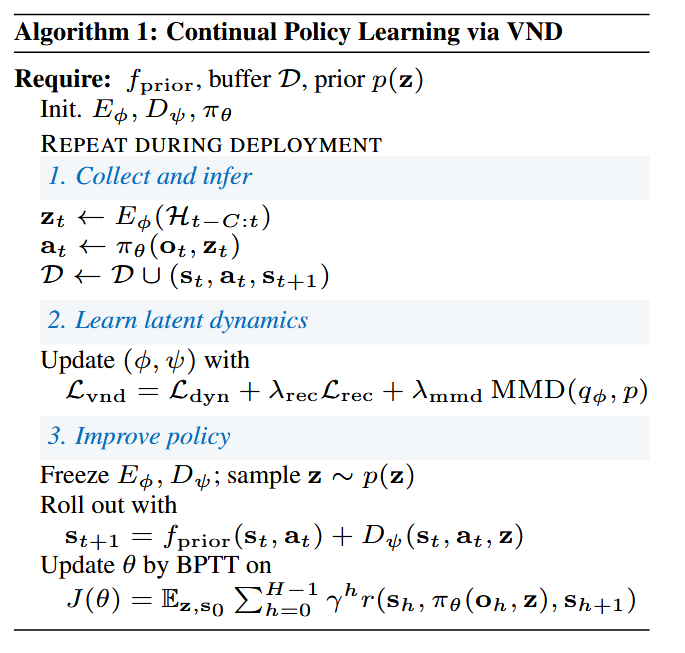
Continual Learning System
总体上在“真实环境交互”和“用可微模型更新策略”之间不断交替进行 base policy:最初在简化的模拟器中训练得到的初始policy buffer D:用来存储真实的交互数据并训练VND model:由已知的analytical physics prior和不断学习的neural residual 组成 z:低维潜变量,从history中得到,代表当前正在影响robot的隐藏状态
- 部署时:从真机交互中encode,使policy根据当前环境改变策略;之后模拟rollout改善策略
- 训练时:采样z,作为模拟器的随机变量
Problem Formulation
将机器人建模为 POMDP(partially observed Markov decision process):\(\mathcal M=(\mathcal S,\mathcal A,\mathcal W,T,r,\gamma)\)。
- \(\mathcal S\):state space
- \(\mathcal A\):action space
- \(\mathcal W\):hidden dynamics condition space
- \(T\):transition dynamics
- \(r\):reward
- \(\gamma\):discount factor 真实状态转移受隐藏动力学条件 \(w\) 影响:\(s_{t+1}\sim T(\cdot\mid s_t,a_t,w)\)。其中 \(w\) 不可直接观测,可表示 wind、payload、friction、hardware degradation 等动力学因素。 利用最近一段 state-action history \(\mathcal H_{t-C:t}\),通过 encoder 得到低维 latent:\(z_t=E_\phi(\mathcal H_{t-C:t})\)。其中 \(z_t\) 表示当前 hidden dynamics condition 的 latent representation,并作为 policy 的条件输入:\(a_t=\pi_\theta(o_t,z_t)\)。即通过历史交互推断当前隐藏动力学,使同一 policy 能适应不同的 dynamics condition。
Variational Neural Dynamics Model
这一部分将前面抽象的状态转移进一步具体化:不直接让神经网络学习完整 dynamics,而是保留已知的 nominal dynamics,只让网络学习其中未建模的 residual dynamics。
给定由历史信息得到的 latent condition \(z_t=E_\phi(\mathcal{H}_{t-C:t})\),下一状态预测为: \[ \hat{\mathbf{s}}_{t+1} = f_{\mathrm{prior}}(\mathbf{s}_t,\mathbf{a}_t) + D_\psi(\mathbf{s}_t,\mathbf{a}_t,\mathbf{z}_t) \] 其中:
- \(f_{\mathrm{prior}}(\mathbf{s}_t,\mathbf{a}_t)\):已知的 nominal dynamics model,描述机器人已经可以解析建模的动力学。对于四旋翼,作者使用不包含 hidden disturbance 的 rigid-body dynamics,并通过 RK4 进行积分。
- \(D_\psi(\mathbf{s}_t,\mathbf{a}_t,\mathbf{z}_t)\):latent-conditioned neural residual dynamics,用于补偿 \(f_{\mathrm{prior}}\) 没有建模的 condition-dependent effects,例如 wind、drag、payload change、friction 或 contact-induced deviation。
- \(\mathbf{z}_t\):由最近的 state-action history 经 GRU encoder \(E_\phi\) 推断得到的 hidden-condition code,因此相同的 \((\mathbf{s}_t,\mathbf{a}_t)\) 在不同 \(\mathbf{z}_t\) 下可以得到不同的 residual correction。
对于四旋翼,\(D_\psi\) 是一个 shared-backbone MLP,并分别具有 position、velocity 和 orientation 三个输出 head: \[ D_\psi(\mathbf{s}_t,\mathbf{a}_t,\mathbf{z}_t) = \left( \Delta\mathbf{p}_{\mathrm{res}}, \Delta\mathbf{v}_{\mathrm{res}}, \Delta\boldsymbol{\xi}_{\mathrm{res}} \right) \] 其中 \(\Delta\mathbf{p}_{\mathrm{res}}\) 和 \(\Delta\mathbf{v}_{\mathrm{res}}\) 分别是 position 和 velocity 的 residual correction;\(\Delta\boldsymbol{\xi}_{\mathrm{res}}\in\mathbb{R}^3\) 是 orientation 的 rotation-vector correction。
这一公式将已知的robot structure与环境影响解耦,从而不需要在不同的环境状态下重新适配模型
Learning an Informative Latent Space
作者不想用 wind direction、payload mass、friction coefficient 等标签规定模型要学习什么物理参数,而是让一个 latent 自行编码 hidden dynamics condition。因此,通过 residual dynamics prediction 来联合训练 encoder \(E_\phi\) 和 residual model \(D_\psi\)。
首先定义真实 transition 相对于 base dynamics 的 residual target: \[ \mathbf{r}_t = \mathbf{s}_{t+1} \ominus f_{\mathrm{prior}}(\mathbf{s}_t,\mathbf{a}_t) \] 这里的 \(\ominus\) 表示适用于 state 的差值运算。对于 position 和 velocity,它就是普通的欧氏空间减法;但 orientation 使用 quaternion 表示,不能直接相减,因此使用 rotation-vector difference。
然后定义 dynamics prediction loss: \[ \mathcal{L}_{\mathrm{dyn}}(\phi,\psi) = \frac{1}{B} \sum_{i=1}^{B} \ell_\delta \left( D_\psi(\mathbf{s}_i,\mathbf{a}_i,\mathbf{z}_{k(i)}) - \mathbf{r}_i \right) \] 其中 \(\ell_\delta\) 是 Huber loss,\(B\) 是一个 batch 中的 transition 数量。 对于一个长度为\(C\)的窗口,作者规定它们共享同一个latent \(z_{k(i)}\),从而迫使encoder学习到一段时间内的环境状态。 这一阶段直接训练好\(Eϕ,Dψ\)
Sampleable Latent Space for Policy Learning
这一段用于将 encoder 学习得到的 latent 与标准高斯分布对齐,从而方便采样。这样一来,部署时\(z_t=E_\phi(\mathcal{H}_{t-C:t})\),训练时 \(z\sim \mathcal{N}(0,I)\)
对于 \(N\) 个 context windows,encoder 输出的 latent 构成 aggregated encoder distribution: \[ q_\phi(\mathbf{z}) = \frac{1}{N} \sum_{n=1}^{N} \delta\left( \mathbf{z}-E_\phi(\mathcal{H}_{n,0:C}) \right) \] 其中 \(\delta(\cdot)\) 是 Dirac measure,\(q_\phi(\mathbf{z})\) 表示所有 context window 经 encoder 得到的 latent 的整体分布。作者选择标准高斯分布作为 sampling prior: \[ p(\mathbf{z})=\mathcal{N}(\mathbf{0},\mathbf{I}) \] 然后利用 Maximum Mean Discrepancy(MMD)将 \(q_\phi\) 与 \(p\) 对齐: \[ \mathcal{L}_{\mathrm{mmd}}(q_\phi,p) = \left\| \mu_k(q_\phi)-\mu_k(p) \right\|_{\mathcal{H}_k}^{2} \] 其中 \(\mu_k(\cdot)\) 是由 RBF kernel 诱导的 kernel mean embedding,\(\mathcal{H}_k\) 是对应的 RKHS。这里的高斯 prior 只是一个方便采样的 latent space,并不表示真实的物理 disturbance 分布。MMD 只负责让整体 latent distribution 与 sampling prior 对齐,latent 的具体动力学信息仍然主要由前面的 dynamics prediction loss 学习。
此外,作者加入 auxiliary reconstruction loss \(\mathcal{L}_{\mathrm{rec}}\):从 latent code 重构 normalized state-action context window,并使用 \(L_2\) loss。其作用是帮助 latent 保留更多 trajectory information,从而提高 dynamics model 的训练精度。
最终 VND 的完整训练目标为: \[ \mathcal{L}_{\mathrm{vnd}} = \mathcal{L}_{\mathrm{dyn}} + \lambda_{\mathrm{rec}}\mathcal{L}_{\mathrm{rec}} + \lambda_{\mathrm{mmd}}\operatorname{MMD}(q_\phi,p) \] 其中 \(\mathcal{L}_{\mathrm{dyn}}\) 让 latent 包含能够区分不同 hidden dynamics 的信息,\(\mathcal{L}_{\mathrm{rec}}\) 帮助 latent 保留 trajectory information,MMD 则使 latent distribution 与可采样的标准高斯 prior 对齐。
#TODO 为什么不用ELBO和KL散度?
Policy Learning with Sampled Latent Dynamics
这个阶段训练\(\theta\) 前一节已经通过 MMD 将 latent distribution 对齐到标准高斯分布,因此在 policy learning 阶段,可以直接从 \[ \mathbf{z}\sim p(\mathbf{z})=\mathcal{N}(\mathbf{0},\mathbf{I}) \] 中采样 latent dynamics condition。
对于每个 simulated rollout,采样一个 \(\mathbf{z}\) 并在整个 rollout 中保持不变。该 \(\mathbf{z}\) 同时输入 policy 和 residual dynamics: \[ \mathbf{a}_t=\pi_\theta(\mathbf{o}_t,\mathbf{z}) \] \[ \mathbf{s}_{t+1} = f_{\mathrm{prior}}(\mathbf{s}_t,\mathbf{a}_t) + D_\psi(\mathbf{s}_t,\mathbf{a}_t,\mathbf{z}) \] 因此不同采样到的 \(\mathbf{z}\) 对应不同的 hidden dynamics condition,policy 会在这些不同 dynamics 下进行训练。
训练时冻结 VND,只更新 policy 参数 \(\theta\),并通过 differentiable rollout 和 BPTT(Backpropagation Through Time)最大化累计 reward: \[ \max_\theta \mathbb{E}_{\mathbf{z}\sim p(\mathbf{z}),\,\mathbf{s}_0\sim\rho_0} \left[ \sum_{t=0}^{H-1} \gamma^t r(\mathbf{s}_t,\mathbf{a}_t,\mathbf{s}_{t+1}) \right] \] 核心就是:从标准高斯中采样不同 latent dynamics,用这些 sampled dynamics 作为可微 simulator 来训练一个 condition-aware policy。